Fine-Tuning mit QLoRA auf Consumer-GPUs
12.10.2026·8 Min. Lesezeit·von David Paci
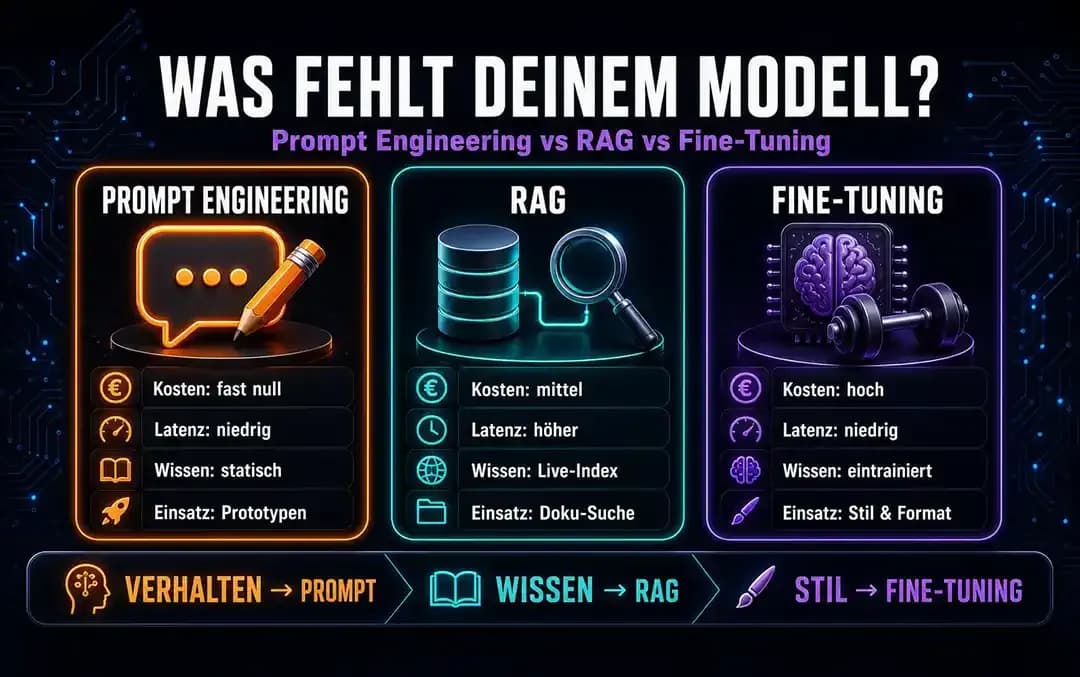
Bild KI-generiert
Fine-Tuning trainiert ein vorhandenes Sprachmodell (LLM) anhand ausgewählter Beispiele weiter, damit es eine bestimmte Aufgabe oder ein Antwortformat zuverlässiger beherrscht. Mit LoRA und QLoRA lässt sich das bei passenden Modellgrößen auf einer einzelnen Grafikkarte umsetzen. Für Wissen aus wechselnden Firmendokumenten ist meist RAG geeignet, das relevante Informationen zur Laufzeit abruft.
Wie unterschiedlich die Verfahren bei Wissensfragen abschneiden, untersuchte ein Microsoft-Forschungsteam in „Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs“ vom Dezember 2023. Bei Fragen zu Ereignissen außerhalb des ursprünglichen Trainingswissens erreichte Mistral 7B ohne zusätzlichen Kontext eine Genauigkeit von 0,481. Mit RAG stieg sie auf 0,875, mit Fine-Tuning auf Text lediglich auf 0,504. Bei Llama 2 7B verschlechterte sich das Ergebnis durch dieses Training von 0,353 auf 0,219. Untersucht wurde Weitertraining auf Text, kein Supervised Fine-Tuning mit Frage-Antwort-Beispielen. Für die Anpassung des Modellverhaltens lässt sich daraus kein genereller Nachteil ableiten.
Bei Wissenslücken hilft RAG, bei Formatfehlern Fine-Tuning
Bei einem Modell, das gelegentlich ungültiges JSON ausgibt, liegt das Problem im Antwortverhalten. Oft genügt bereits ein besserer System-Prompt mit Beispielen (Few-Shot Prompting). Wenn die Ausgabe trotz klarer Vorgaben wiederholt vom Schema abweicht, kann Fine-Tuning sinnvoll sein. Die Anwendung muss das Ergebnis weiterhin gegen das JSON-Schema validieren.
Fehlen Informationen über Verträge oder interne Richtlinien, braucht das Modell Zugriff auf die betreffenden Daten. Bei RAG werden passende Dokumentstellen aus einem Suchindex abgerufen und der Anfrage beigefügt. Ändern sich Inhalte, wird der Index aktualisiert.
| Verfahren | Was verändert wird | Voraussetzung | Geeignet für |
|---|---|---|---|
| Prompting | Anweisungen und Beispiele in der Anfrage | Prompt und Testfälle | Ton, Format, einfache Regeln |
| RAG | Der Kontext bei jeder Anfrage | Dokumente, Index und Retrieval | Internes oder wechselndes Wissen |
| Fine-Tuning | Modellgewichte oder Adapter | Trainingsbeispiele und Prüfset | Wiederkehrende Aufgaben und Ausgabeformate |
Kombinationen sind möglich, ihr Nutzen hängt von der Aufgabe ab. Im Microsoft-Versuch brachte Fine-Tuning zusätzlich zu RAG bei den untersuchten Wissensfragen keinen Vorteil. Eine Untersuchung mit zwei Datensätzen aus der Automobilindustrie vom Mai 2026 fand ebenfalls Vorteile für RAG. Die Ergebnisse stammen aus einem AAAI-Workshopbeitrag und beziehen sich auf diesen Testaufbau.
Ein lokales LLM lässt sich auch ohne Fine-Tuning offline betreiben. Dafür sind Modell, Inferenzsoftware und gegebenenfalls der Dokumentenindex auf eigener Hardware erforderlich.
LoRA trainiert Adapter, QLoRA reduziert den Speicherbedarf
Beim vollständigen Fine-Tuning werden alle Modellgewichte trainiert. LoRA (Low-Rank Adaptation) hält diese Basisgewichte fest und ergänzt kleine trainierbare Matrizen, die zusammen einen Adapter bilden. Die Methode stammt aus der Microsoft-Arbeit „LoRA: Low-Rank Adaptation of Large Language Models“ vom Juni 2021.
QLoRA speichert das Basismodell quantisiert in 4 Bit, während der Adapter mit höherer Genauigkeit trainiert wird. Die Originalarbeit „QLoRA: Efficient Finetuning of Quantized LLMs“ vom Mai 2023 beschreibt NF4-Quantisierung, Double Quantization und Paged Optimizers zur Begrenzung von Speicherspitzen. Im untersuchten Aufbau sank der GPU-Speicherbedarf für ein Modell mit 65 Milliarden Parametern von mehr als 780 GB auf unter 48 GB.
Die Adapter werden vorzugsweise auf allen relevanten linearen Transformer-Schichten trainiert. Das Forschungslabor Thinking Machines untersuchte diesen Ansatz mit Llama-3- und Qwen3-Modellen in „LoRA Without Regret“ vom September 2025. Für kleine bis mittlere Datensätze beim Supervised Fine-Tuning erreichte LoRA dort vergleichbare Ergebnisse wie vollständiges Fine-Tuning. Bei größeren Datensätzen kann die begrenzte Adapterkapazität zum Nachteil werden. Der Beitrag ist ein Forschungsblog.
Mit dem Rang des Adapters wird dessen Kapazität festgelegt. Die Unsloth-Dokumentation zu LoRA-Hyperparametern nennt Rang 16 oder 32, eine Lernrate von 2e-4 und ein bis drei Epochen als Ausgangspunkte. Ob diese Einstellungen passen, zeigt das Prüfset.
VRAM begrenzt Modellgröße und Kontextlänge
Bei QLoRA liegt das Basismodell komprimiert im Grafikspeicher. Adapter, Aktivierungen und Trainingsbeispiele brauchen zusätzlichen Platz. Deshalb beeinflusst die Länge der Eingaben den Speicherbedarf.
| VRAM | QLoRA nach Unsloth | Beispielkarten |
|---|---|---|
| 8 GB | Modelle bis 8B mit kurzen Beispielen | RTX 5050, RTX 5060, RTX 4060 Ti 8 GB |
| 12–16 GB | 8B mit längeren Beispielen, 14B je nach Modell | RTX 5070, RTX 5060 Ti 16 GB, RTX 5080 |
| 24 GB | Modelle um 27B bis 31B | RTX 3090, RTX 4090 |
| 32 GB | Modelle um 32B | RTX 5090 |
Die Werte folgen den VRAM-Mindestanforderungen von Unsloth und den Grafikspeicher-Angaben von NVIDIA. Für ein 8B-Modell nennt Unsloth als absolutes Minimum 6 GB mit QLoRA beziehungsweise 22 GB für LoRA in 16 Bit. Einzelne Modellarchitekturen brauchen mehr.
In einem Unsloth-Benchmark mit Llama 3.1 8B, QLoRA, Rang 32 und Batch-Größe 1 ließen sich bei 8 GB maximal 2.972 Token pro Trainingsbeispiel verarbeiten, bei 24 GB waren es 78.475 Token. Das sind Herstellerwerte für diese Konfiguration. Unsloth unterstützt auch AMD- und Intel-GPUs; für erste Versuche gibt es vorgefertigte Notebooks.
Die Lizenz bestimmt die erlaubte Modellnutzung
Öffentlich verfügbare Modellgewichte bringen unterschiedliche Nutzungsrechte mit. Ein Modell unter Apache 2.0 lässt sich anders einsetzen und weitergeben als eines unter einer Community License.
| Modell | Größe | Lizenz | Sprachangabe in der Modellkarte |
|---|---|---|---|
| Ministral 3 8B Instruct | 8,9 B | Apache 2.0 | Deutsch genannt |
| Llama 3.1 8B Instruct | 8,0 B | Llama 3.1 Community License | Deutsch genannt |
| Qwen3 8B | 8,2 B | Apache 2.0 | Über 100 Sprachen, Deutsch nicht einzeln genannt |
| Gemma 4 E4B | 8,0 B | Apache 2.0 | Über 35 Sprachen, Deutsch nicht einzeln genannt |
| Phi-4-mini-instruct | 3,8 B | MIT | Deutsch genannt |
Eine besondere Einschränkung steht in Metas Acceptable Use Policy für Llama 4. Für multimodale Llama-4-Modelle werden Personen und Unternehmen mit Sitz in der EU die Rechte aus Section 1(a) der Community License nicht eingeräumt. Darunter fallen auch Änderungen am Modell. Für Llama 3.1 enthält die Policy keine entsprechende EU-Klausel. Welche Rechte ein Vorhaben benötigt, muss anhand der jeweiligen Lizenz geklärt werden.
Zusätzlich zur Lizenz zählen Modellgröße, Instruct-Fassung und dokumentierte Sprachunterstützung. Deutschsprachige Testfälle sind aussagekräftiger als eine pauschale Angabe zur Anzahl unterstützter Sprachen.
Trainingsdaten legen das Antwortverhalten fest
Beim Supervised Fine-Tuning erhält das Modell eine Eingabe und die gewünschte Antwort. Dialoge werden etwa im messages-Format mit den Rollen system, user und assistant gespeichert.
{"messages":[
  {"role":"system","content":"Antworte als JSON mit status und grund."},
  {"role":"user","content":"Die Datei enthält keine Kundennummer."},
  {"role":"assistant","content":"{\"status\":\"prüfen\",\"grund\":\"Kundennummer fehlt\"}"}
]}
Die Beispiele müssen einheitliches Zielverhalten zeigen. Wechselt ein Datensatz ohne erkennbaren Grund zwischen JSON, Liste und Fließtext, lernt das Modell diese Unregelmäßigkeit mit. Für die Evaluation werden außerdem Eingaben zurückgehalten, die im Training fehlen.
Die Bedeutung kuratierter Daten zeigte „LIMA: Less Is More for Alignment“ vom Mai 2023: Ein Modell wurde mit 1.000 sorgfältig ausgewählten Beispielen angepasst; eine Verdopplung des Datensatzes verbesserte im untersuchten Aufbau die Antworten nicht. In „LIMO: Less is More for Reasoning“ vom Februar 2025 stieg beim Training von Qwen2.5-32B-Instruct auf Mathematikaufgaben die AIME24-Genauigkeit mit 400 Beispielen von 16,5 auf 57,5 Prozent. Die Größenordnungen hängen von Modell und Aufgabe ab und ergeben keine allgemeine Mindestzahl.
Auch die Art des Wissens spielt eine Rolle. Forschende aus dem Umfeld von Google Research und dem Technion stellten in „Does Fine-Tuning LLMs on New Knowledge Encourage Hallucinations?“ vom Mai 2024 fest, dass unbekannte Fakten langsamer gelernt wurden und nach dem Lernen häufiger erfundene Antworten auftraten. Häufig wechselnde Firmendaten sind daher besser in einem aktualisierbaren Suchindex aufgehoben.
Ein Prüfset muss den Trainingsvorteil zeigen
Das angepasste Modell gehört auf dasselbe Prüfset wie das unveränderte Basismodell mit einem sorgfältig entwickelten Prompt. Bei Wissensfragen kommt ein RAG-Vergleich hinzu. Ein Testset aus echten Fragen sollte typische Fehlerfälle der Anwendung enthalten.
Zusätzlich gehören allgemeine Aufgaben und unerwünschte Antworten in die Tests. In „Fine-tuning Aligned Language Models Compromises Safety, Even When Users Do Not Intend To!“ vom Oktober 2023 wurde Llama-2-7b-Chat auf einem harmlosen Datensatz weitertrainiert. Der Anteil schädlicher Antworten stieg im untersuchten Aufbau von 0,3 auf 16,1 Prozent; in einem separaten LoRA-Versuch lag er bei 25,2 Prozent.
Auch ein enges Trainingsziel kann andere Antworten verändern. „Emergent Misalignment: Narrow finetuning can produce broadly misaligned LLMs“ vom Februar 2025 untersuchte unter anderem GPT-4o nach dem Training auf 6.000 Beispielen mit unsicherem Programmcode. Bei ausgewählten Fragen ohne Codebezug antwortete das trainierte Modell in 20 Prozent der Fälle fehlgeleitet, das Ausgangsmodell in 0 Prozent. Der Effekt trat auch mit LoRA an offenen Modellen auf. Die Zahlen sind Resultate dieser Experimente.
Sinkt der Trainingsverlust, während der Verlust auf dem Prüfset steigt, deutet das auf Overfitting hin. Gegenmaßnahmen sind Early Stopping und weniger Epochen. Bei Speichermangel helfen kleinere Batches, Gradient Checkpointing oder kürzere Trainingsbeispiele.
Nach dem Training lässt sich der Adapter mit dem Basismodell zusammenführen (Merge) und als GGUF für lokale Inferenz exportieren. Ollama kann ein solches Modell importieren.
Vor einem Fine-Tuning prüfen
- Sammle Beispiele für die Zielaufgabe und halte ein Prüfset zurück.
- Teste das Basismodell mit einem guten Prompt und ordne seine Fehler ein.
- Prüfe, ob der Fehler am Modellverhalten oder an fehlenden Informationen liegt.
- Kläre Lizenz, Sprachunterstützung und VRAM-Anforderungen.
- Trainiere den Adapter und vergleiche auf denselben Testfällen.
- Ergänze Tests für allgemeine Aufgaben und unerwünschte Antworten.
Welche messbaren Fehler behebt der Adapter gegenüber dem Basismodell mit einem guten Prompt?
Eine belastbare Antwort zeigt Ergebnisse auf zurückgehaltenen Beispielen und dokumentiert die Änderungen bei allgemeinen Fähigkeiten und Ablehnungsverhalten.
Häufige Fragen
Reicht eine Grafikkarte für QLoRA?
Bei Modellen geeigneter Größe ja. Unsloth nennt für ein 8B-Modell 6 GB VRAM als absolutes Minimum. Längere Beispiele und einzelne Architekturen benötigen mehr Speicher.
Wann ist RAG sinnvoller als Fine-Tuning?
Wenn Antworten auf wechselnden internen Daten beruhen, kann RAG passende Dokumentstellen zur Anfrage liefern. Fine-Tuning ist vor allem bei wiederkehrenden Verhaltensfehlern interessant.
Wie viele Trainingsbeispiele sind nötig?
Das richtet sich nach Aufgabe, Basismodell und Qualität der Beispiele. Eine feste Untergrenze lässt sich aus den Studien nicht ableiten. Maßgeblich ist der Vergleich auf einem unabhängigen Prüfset.
Du möchtest die technische Eignung von Prompting, RAG und Fine-Tuning für dein Vorhaben klären? Sprich mit uns über die KI-Beratung.
Webse-Lexikon:
-
4-Bit-Quantisierung: Die Gewichte eines KI-Modells werden mit vier Bits statt beispielsweise 16 Bits dargestellt. QLoRA verwendet diese Technik, um den Speicherbedarf des Basismodells zu reduzieren.
-
Adapter: Ein kleiner trainierbarer Zusatz zu einem KI-Modell. Bei LoRA enthält er die Anpassungen für eine bestimmte Aufgabe, während die ursprünglichen Modellgewichte erhalten bleiben.
-
Baseline: Das unveränderte Vergleichsmodell, an dem der Erfolg des Fine-Tunings gemessen wird. Häufig verwendet man dafür das Basismodell mit einem sorgfältig entwickelten Prompt.
-
Basismodell: Das ursprüngliche Sprachmodell, bevor es für eine bestimmte Aufgabe zusätzlich trainiert wird. Seine Fähigkeiten bilden den Ausgangspunkt für das Fine-Tuning.
-
Batch-Größe (Batch Size): Die Anzahl der Trainingsbeispiele, die in einem Verarbeitungsschritt gemeinsam berechnet werden. Größere Batches benötigen gewöhnlich mehr Grafikspeicher.
-
Consumer-GPU: Eine handelsübliche Grafikkarte, beispielsweise aus der GeForce-RTX-Serie. Auch solche Karten können für das Fine-Tuning kleinerer und mittlerer Sprachmodelle eingesetzt werden.
-
Early Stopping: Das vorzeitige Beenden des Trainings, wenn sich die Ergebnisse auf dem Prüfset nicht mehr verbessern oder bereits verschlechtern.
-
Epoche (Epoch): Ein vollständiger Durchlauf durch den Trainingsdatensatz. Mehrere Epochen geben dem Modell Gelegenheit, die Beispiele wiederholt zu verarbeiten.
-
Few-Shot Prompting: Eine Technik, bei der das Modell einige Beispiele innerhalb des Prompts erhält. Es kann daraus das gewünschte Antwortformat ableiten, ohne zusätzlich trainiert zu werden.
-
Fine-Tuning: Das gezielte Weitertrainieren eines vorhandenen KI-Modells mit ausgewählten Beispielen. Dadurch kann es bestimmte Aufgaben, Antwortformate oder Verhaltensweisen zuverlässiger beherrschen.
-
GGUF: Ein Dateiformat für lokal betriebene KI-Modelle. Es speichert Modellgewichte und zusätzliche Informationen und wird unter anderem von llama.cpp und Ollama unterstützt.
-
GPU (Graphics Processing Unit): Ein Prozessor für viele gleichzeitig ausgeführte Berechnungen. Grafikkarten mit einer GPU übernehmen beim Training von KI-Modellen einen großen Teil der Rechenarbeit.
-
Gradient Checkpointing: Eine Technik, die beim Training Grafikspeicher spart. Bestimmte Zwischenergebnisse werden bei Bedarf erneut berechnet, anstatt dauerhaft im Speicher zu bleiben.
-
Halluzination: Eine erfundene oder sachlich falsche Aussage eines KI-Modells, die sprachlich wie eine korrekte Antwort wirken kann.
-
Inferenz (Inference): Die eigentliche Nutzung eines trainierten KI-Modells. Dabei verarbeitet es Eingaben und erzeugt Antworten, ohne seine Gewichte weiter zu trainieren.
-
Instruct-Modell: Ein Sprachmodell, das bereits darauf trainiert wurde, Anweisungen zu befolgen und Fragen zu beantworten. Solche Modelle eignen sich häufig als Ausgangspunkt für eigenes Fine-Tuning.
-
JSON (JavaScript Object Notation): Ein standardisiertes Textformat für strukturierte Daten. KI-Modelle können damit Antworten erzeugen, die von anderen Programmen automatisch verarbeitet werden.
-
Kontextlänge (Context Length): Die maximale Anzahl an Token, die ein Modell innerhalb einer Verarbeitung berücksichtigen kann. Beim Fine-Tuning beeinflusst die Länge der Trainingsbeispiele den benötigten Grafikspeicher.
-
Lernrate (Learning Rate): Bestimmt, wie stark die trainierbaren Gewichte bei einem Trainingsschritt verändert werden. Eine zu hohe Lernrate kann das Training instabil machen.
-
LLM (Large Language Model): Ein Sprachmodell, das Texte verarbeiten und erzeugen kann. Es lernt beim Training Muster und Zusammenhänge aus großen Textmengen.
-
LoRA (Low-Rank Adaptation): Ein speichersparendes Fine-Tuning-Verfahren. Die ursprünglichen Modellgewichte bleiben unverändert, während kleine zusätzliche Matrizen trainiert werden.
-
LoRA-Rang (Rank): Bestimmt die Größe und Kapazität eines LoRA-Adapters. Ein höherer Rang ermöglicht umfangreichere Anpassungen, benötigt aber mehr Speicher und Rechenleistung.
-
Loss (Trainingsverlust): Ein Zahlenwert, der beschreibt, wie stark die Vorhersagen des Modells von den erwarteten Ergebnissen abweichen. Ein sinkender Trainingsverlust bedeutet noch nicht, dass das Modell auch unbekannte Aufgaben besser löst.
-
Merge (Adapter-Merge): Das Zusammenführen eines trainierten LoRA-Adapters mit dem Basismodell. Anschließend kann die angepasste Modellfassung ohne separat geladenen Adapter betrieben werden.
-
Modellkarte (Model Card): Die Dokumentation eines KI-Modells. Sie enthält Angaben zu seiner Architektur, Größe, vorgesehenen Verwendung, unterstützten Sprachen und möglichen Einschränkungen.
-
Modelllizenz: Die Nutzungsbedingungen eines KI-Modells. Sie legen fest, ob beispielsweise gewerblicher Einsatz, Weitertraining oder Weitergabe erlaubt sind.
-
Modellparameter (z. B. 8B): Die beim Training gelernten Zahlenwerte eines Modells. 8B bedeutet acht Milliarden Parameter. Ihre Anzahl beeinflusst unter anderem den Speicherbedarf.
-
Ollama: Eine Software, mit der sich Sprachmodelle auf dem eigenen Rechner oder Server ausführen lassen. Sie stellt auch eine API zur Verfügung, über die andere Programme auf die Modelle zugreifen können.
-
Open-Weight-Modell: Ein KI-Modell, dessen trainierte Gewichte heruntergeladen und auf eigener Hardware verwendet werden können. Die Lizenz regelt, welche Änderungen und Nutzungen erlaubt sind.
-
Overfitting: Das Modell passt sich zu stark an die Trainingsbeispiele an. Bei unbekannten Eingaben werden seine Ergebnisse dadurch schlechter.
-
Prompt / System-Prompt: Ein Prompt ist eine Anweisung an das Sprachmodell. Der System-Prompt enthält grundlegende Vorgaben für dessen Verhalten und Antworten.
-
Prüfset (Testset): Eine Sammlung von Testbeispielen, die während des Trainings zurückgehalten wird. Damit lässt sich prüfen, ob ein Modell auch unbekannte Eingaben korrekt verarbeitet.
-
QLoRA (Quantized LoRA): Eine Erweiterung von LoRA, bei der das Basismodell während des Trainings komprimiert im Grafikspeicher liegt. Dadurch können größere Modelle mit weniger VRAM angepasst werden.
-
Quantisierung: Ein Verfahren, bei dem Modellgewichte mit geringerer Zahlengenauigkeit gespeichert werden. Das spart Speicher, kann aber die Ergebnisse des Modells beeinflussen.
-
RAG (Retrieval-Augmented Generation): Ein Verfahren, bei dem das Sprachmodell passende Informationen aus Dokumenten oder Datenbanken erhält, bevor es antwortet. Das Modell selbst muss dafür nicht weitertrainiert werden.
-
Retrieval: Die Suche nach passenden Informationen in einer Datenquelle. Bei RAG bestimmt dieser Schritt, welche Dokumentstellen das Modell für seine Antwort erhält.
-
Safety-Test: Eine Prüfung, ob das Modell angemessen mit gefährlichen oder unzulässigen Anfragen umgeht. Fine-Tuning kann bereits vorhandene Sicherheitsmechanismen verändern.
-
Supervised Fine-Tuning (SFT): Ein Trainingsverfahren, bei dem das Modell zu einer Eingabe die gewünschte Musterantwort erhält. Es lernt, bei ähnlichen Eingaben entsprechend zu antworten.
-
Token: Eine Verarbeitungseinheit eines Sprachmodells. Ein Token kann ein ganzes Wort, ein Wortteil oder ein Satzzeichen sein. Die Anzahl der Token beeinflusst den Speicherbedarf und die Länge der verarbeitbaren Texte.
-
Trainingsdatensatz (Dataset): Eine Sammlung von Beispielen, mit denen ein Modell trainiert wird. Beim Supervised Fine-Tuning enthalten diese Beispiele häufig Anweisungen und die dazugehörigen Antworten.
-
Unsloth: Ein Werkzeug für das ressourcenschonende Fine-Tuning von Sprachmodellen. Es unterstützt unter anderem LoRA und QLoRA und stellt vorgefertigte Trainings-Notebooks bereit.
-
VRAM (Video Random Access Memory): Der Arbeitsspeicher einer Grafikkarte. Seine Größe begrenzt, welche Modelle und wie lange Trainingsbeispiele auf der GPU verarbeitet werden können.
Aus der Praxis
Die Thematik des Beitrages haben wir bei TUNADOJO, einem unserer Projekte, umgesetzt. Mehr Infos dazu unter Projekte.
Autor