RAG erklärt: Was KMU wissen müssen
12.5.2026·9 Min. Lesezeit·von David Paci
Bild KI-generiert
Jedes Unternehmen hat ein Wissensproblem. Preislisten in unterschiedlichen Ordnern, Prozessdokumente auf dem Firmenserver und Erfahrungswissen in den Köpfen langjähriger Mitarbeiter. Wenn jemand kündigt, geht Wissen verloren, und wenn ein neuer Kollege anfängt, dauert es oft Monate bis er sich auskennt. Und wenn ein Kunde abends um 21 Uhr eine Frage hat, kann niemand antworten.
KI-Tools wie ChatGPT haben daran wenig geändert, denn Sie wissen viel über die Welt, aber nichts über deine Firma. Frag ChatGPT nach deinem Reklamationsprozess, nach deinen Sonderkonditionen für Stammkunden oder nach dem Wartungsintervall deiner Spezialmaschine - du bekommst bestenfalls eine allgemeine Antwort, schlimmstenfalls eine frei erfundene.
Genau dieses Problem löst RAG. Es lohnt sich zu verstehen, was dahintersteckt - in diesem Artikel zeigen wir dir welche Aufgaben RAG für dich löst und wo die Grenzen von RAG sind.
Was RAG eigentlich ist
RAG steht für Retrieval-Augmented Generation. Auf Deutsch: abruferweiterte Generierung. Das klingt sperrig, die Idee dahinter ist aber simpel.
Stell dir einen neuen Mitarbeiter vor. Hochintelligent, sprachlich perfekt, lernwillig. Aber am ersten Tag weiß er nichts über deine Firma. Er kennt weder deine Produkte noch deine Preise noch deinen Ablauf bei Reklamationen. Was tust du? Du gibst ihm die Unterlagen zum Lesen.
RAG macht genau das mit einer KI. Du gibst ihr deine Dokumente, deine Produktdaten, deine Prozessbeschreibungen. Und plötzlich kann sie Fragen beantworten, die nur jemand beantworten könnte, der sich in deinem Unternehmen auskennt.
Der Unterschied zu „alles in ChatGPT reinkopieren" ist dabei entscheidend: Ein RAG-System durchsucht deine Dokumente intelligent nach Bedeutung, nicht nach Stichwörtern. Wenn jemand nach einer „wasserdichten Jacke" fragt, findet das System auch „Regenschutzbekleidung". Und deine Daten bleiben dabei auf deinem Server und landen nicht auf amerikanischen Plattformen.
Wie RAG funktioniert
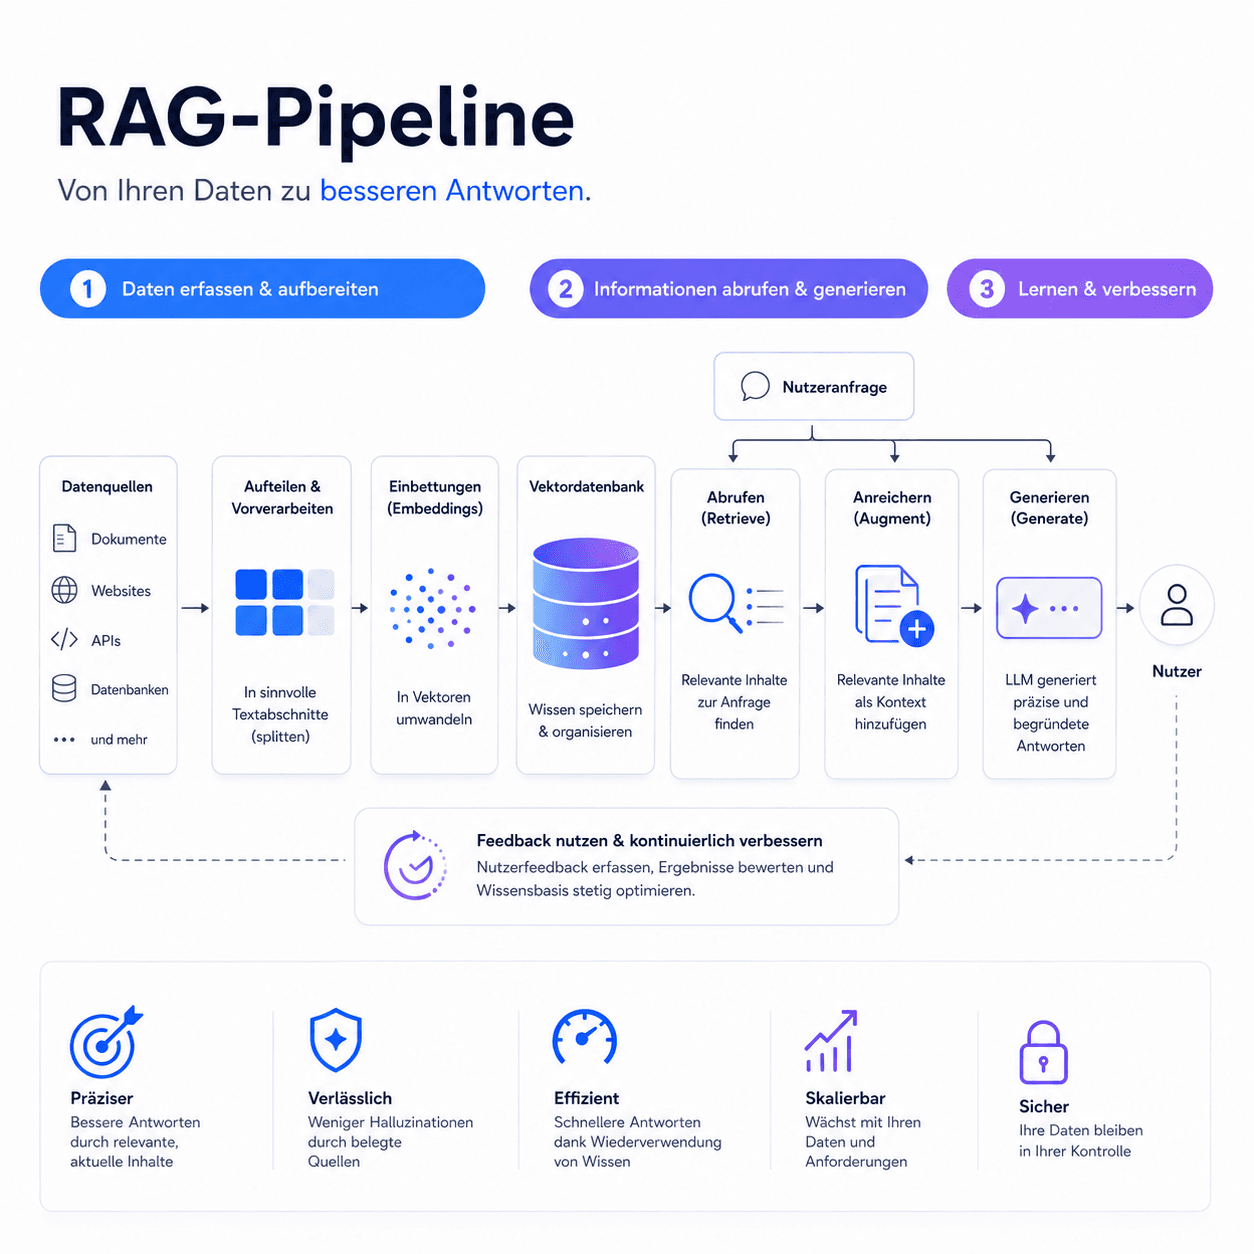
Der Prozess hat drei Schritte, die der Name schon verrät:
Abruf: Ein Nutzer stellt eine Frage. Das System durchsucht deine Wissensdatenbank und findet die relevantesten Textabschnitte — nicht per Stichwortsuche, sondern basierend auf der Bedeutung der Frage.
Erweiterung: Die gefundenen Passagen werden zusammen mit der Frage an ein Sprachmodell übergeben. Die KI bekommt also nicht nur die Frage, sondern auch die richtigen Informationen aus deinen Dokumenten dazu.
Generierung: Das Sprachmodell formuliert eine verständliche Antwort — basierend auf deinen echten Daten. Nicht auf Vermutungen, nicht auf allgemeinem Internetwissen.
Damit das funktioniert, werden deine Dokumente vorher aufbereitet: in sinnvolle Abschnitte zerteilt und in einer speziellen Datenbank gespeichert. Das passiert einmal bei der Einrichtung und danach bei jeder Aktualisierung. Der laufende Betrieb kostet überraschend wenig.

Wenn die Information nur als Scan vorliegt
In vielen Betrieben liegt der ältere Teil der Unterlagen als Scan auf dem Laufwerk, etwa Akten, Pläne und ausgefüllte Formulare. Die Dateisuche findet dann die Datei, aber nicht die Stelle darin. Eine Texterkennung (OCR) hilft bei sauberen Vorlagen und liefert bei schlechten wenig bis nichts.
Für solche Bestände gibt es einen zweiten Weg. Beim bildbasierten Abruf (Visual RAG) liest das System die Seite als Bild und erfasst dabei Layout, Tabellen und Diagramme mit. Eine Tabelle bleibt eine Tabelle, und der Verweis in der Antwort zeigt auf die konkrete Seite, auf der die Angabe steht.
Dieser Weg ist aufwendiger als reine Textverarbeitung und lohnt sich nicht überall. Wo Datenblätter, Wartungshistorien und Normen in tausenden PDFs liegen, ist er oft der einzige, mit dem dieser Bestand überhaupt durchsuchbar wird.
Warum nicht einfach ChatGPT?
Drei Gründe, die im KMU-Alltag zählen:
Datenschutz. Deine Preislisten, Verträge und internen Prozesse haben auf amerikanischen Servern nichts verloren. Ein RAG-System kann vollständig auf europäischen Servern laufen — mit einem französischen KI-Anbieter, auf deutschen Servern, DSGVO-konform.
Menge. ChatGPT hat ein begrenztes Textfenster. Deine 500 Produktdatenblätter passen da nicht rein. Ein RAG-System findet automatisch die drei bis fünf relevanten Seiten aus Tausenden.
Aktualität. ChatGPT hat einen Wissensstand, der Monate zurückliegt. Ein RAG-System hat den Stand von heute, weil es deine aktuellen Dokumente durchsucht.
Nicht jede Frage braucht dieselbe Suche
Die Beschreibung oben lässt aber einen Punkt aus. Bedeutungsbasierte Suche ist stark bei Fragen an Fließtext. Bei Zahlen aus einer Tabelle ist sie ungenau, und bei Fragen, die zwei Dinge verbinden müssen, versagt sie oft ganz. „Welche Fristen hängen an den Fällen von Kunde Z?" verlangt, dass jemand Personen, Fälle und Termine zusammenführt - dafür ist eine Ähnlichkeitssuche das falsche Werkzeug.
In einem gut gebauten System liegen deshalb mehrere Verfahren nebeneinander.
| Deine Daten | Deine Frage | Das passende Verfahren |
|---|---|---|
| Texte, Handbücher, PDFs | „Was steht zu X?" | Bedeutungsbasierte Suche (Vektorsuche) |
| Zahlen und Tabellen | „Was hat Kunde Y im März bestellt?" | Abfrage direkt auf der Datenbank, exakt |
| Verknüpfte Angaben | „Welche Fristen hängen an den Fällen von Z?" | Wissensgraph |
| Stabiles Kernwissen | Wiederkehrende Standardfragen | Zwischenspeicher, sofort und günstig |
Diese Wahl trifft nicht der Nutzer. Eine vorgeschaltete Weiche (Router) erkennt an der Frage, welches Verfahren passt, und kombiniert häufig mehrere davon. Wie das Zusammenspiel aus Bedeutungssuche und klassischer Stichwortsuche im Detail arbeitet, steht in Warum gute Suche mehr als Vektorsuche braucht.
Konkrete Use Cases für Unternehmen
Wo RAG einen echten Unterschied macht, hängt von der Branche ab. Hier sind die wichtigsten Einsatzfelder — ohne Übertreibung, basierend auf dem, was heute produktionsreif funktioniert.
Kundenservice und Vertrieb
Ein Chatbot auf deiner Website, der nicht nur „Wie kann ich helfen?" fragt, sondern deine Produkte, Preise und Verfügbarkeiten tatsächlich kennt. Ein Kunde fragt: „Machen Sie auch Fassadendämmung bei Altbau mit Denkmalschutz?" — und bekommt eine fundierte Antwort statt einer Vertröstung. Das funktioniert 24 Stunden am Tag, in mehreren Sprachen, ohne Personalkosten.
Für Vertriebsteams: „Was haben wir Kunde Müller letztes Mal angeboten?" oder „Welche Argumente gegen Mitbewerber X?" — das System durchsucht CRM-Notizen, alte Angebote und Wettbewerbsanalysen.
Internes Wissensmanagement
Das Wissen, das in Köpfen, E-Mails und Ordnern verstreut ist, wird zentral durchsuchbar. Neue Mitarbeiter stellen dem System ihre Fragen statt dem genervten Kollegen. Einarbeitungszeit: von drei Monaten auf einen.
Für Techniker im Außendienst: „Welches Dichtungskit für Pumpenmodell XR-450, Baujahr 2017?" — Teilenummer plus Einbauanleitung, direkt aufs Handy.
Dokumentenanalyse und Compliance
Eingehende Verträge gegen eigene Standards prüfen. Neue Vorschriften gegen bestehende Prozesse abgleichen. Ausschreibungen auf Machbarkeit prüfen — das System durchsucht Referenzprojekte, Zertifizierungen und Kapazitäten.
Branchenspezifische Anwendungen
Kanzleien: Akten, Fristen, Schriftsätze und Präzedenzfälle. Die Frage nach allen Fristen eines Mandanten muss mehrere Akten verbinden, und genau daran scheitert eine einfache Suche. Weil es um Mandantendaten geht, läuft ein solches System auf europäischen Servern oder im eigenen Haus.
Immobilienverwaltung: Mieterdaten, Verträge, Betriebskosten, Wartungsprotokolle. „Wann wurde die Heizung in Top 3 zuletzt gewartet?"
Produktion: Maschinenhandbücher, Wartungspläne, Fehlercodes. „Maschine zeigt Fehlercode E-412 — was tun?" — Antwort inklusive Anleitung.
Gastronomie und Hotellerie: Speisekarten, Allergeninfos, Hausregeln, lokale Tipps für Gäste. In jeder Sprache.
Handwerk: Produktdatenblätter, Einbauanleitungen, Materialvergleiche. Der Geselle auf der Baustelle hat das gesamte Firmenwissen in der Hosentasche.
Die Kosten von RAG
Die Infrastrukturkosten für ein RAG-System sind für die meisten KMU überraschend niedrig. Sie hängen vor allem an der Zahl der Anfragen und an der Wahl von KI-Anbieter und Server.
Die Projektkosten für die Einrichtung hängen vom Umfang ab: wie viele Seiten oder Dokumente aufbereitet werden, in welcher Form sie vorliegen und wo das System eingebunden wird. Ein Standard-Chatbot kann in zwei bis drei Wochen live sein.
RAG kann nicht alles
Fairerweise: RAG ist kein Wundermittel. Die Qualität der Antworten steht und fällt mit der Qualität deiner Dokumente. Wenn deine Produktdatenblätter veraltet sind, gibt das System veraltete Antworten. Wenn deine Prozessdokumentation lückenhaft ist, sind es die Antworten auch.
RAG ersetzt auch keine strategischen Entscheidungen. Es kann Informationen finden und aufbereiten, aber es „versteht" dein Geschäft nicht im menschlichen Sinne. Es ist ein Werkzeug, kein Berater.
Und: Die Einrichtung erfordert technisches Know-how. Wie Dokumente zerteilt werden, welches Embedding-Modell zum Einsatz kommt und wie die Suchqualität optimiert wird, sind keine trivialen Prozesse. Hier trennt sich Expertise von Spielerei und Experimentierfreude.
Wicht zu erwähnen: nicht jeder Fall braucht ein eigenes System. Für ein überschaubares FAQ in einem kleinen Shop reicht ein fertiger Chatbot, der die Website ausliest. Der Aufwand lohnt sich vor allem dort, wo eine Standardlösung an ihre Grenze stößt, z.B. bei Zugriffsrechten pro Abteilung oder bei Fragen, die mehrere Quellen verbinden müssen.
Häufige Fragen
Verlassen meine Daten das Haus? Nein. Ein Wissenssystem kann vollständig auf Servern in Österreich oder Deutschland laufen, auf Wunsch auf deiner eigenen Infrastruktur. Deine Dokumente bleiben unter deiner Kontrolle, und es wird kein öffentliches Modell mit ihnen trainiert.
Können wir das an unsere bestehenden Programme anbinden? Ja. Für die Anbindung von Datenquellen und Assistenten gibt es inzwischen einen Standard, das Model Context Protocol (MCP). Wo eine Software keine Schnittstelle mitbringt, bauen wir sie.
Funktioniert das auch mit Scans, Tabellen und Plänen? Ja, über den bildbasierten Abruf (Visual RAG), der weiter oben beschrieben ist. Das System liest die Seite als Bild und erfasst Layout und Tabellen mit, nicht allein den reinen Text.
Über webse.at
webse.at ist eine Villacher Webagentur, die Erstellung von Websites, komplexen Web-Anwendungen und KI gestützter Automation von betrieblichen Prozessen anbietet. Mit Jukeep betreibt webse.at ein eigenes RAG-basiertes Wissensmanagement-Produkt, das Thema ist also nicht Theorie, sondern tägliche Praxis. Dazu kommen eigene Open-Source-Bibliotheken für Embedding-Migration, zeitgewichtete Vektorsuche und semantische Deduplizierung, die RAG-Systeme robuster machen. Alle Systeme laufen DSGVO-konform auf europäischer Infrastruktur.
Wenn du wissen willst, ob sich das für deinen Betrieb rechnet, sieh dir unsere KI-Beratung an.
🎙️ Die ausführliche Diskussion gibt es in unserer Podcast-Episode: Auf Spotify anhören →
WEBSE-Lexikon:
- RAG (Retrieval-Augmented Generation): Technologie, die einem KI-Sprachmodell Zugang zu externen Datenquellen gibt. Statt aus dem Trainingswissen zu antworten, durchsucht die KI zuerst eine Wissensdatenbank und antwortet auf Basis der gefundenen Dokumente. Reduziert Halluzinationen und ermöglicht firmenspezifische Antworten.
- Embedding: Eine mathematische Darstellung eines Textes als Zahlenvektor. Erfasst die Bedeutung statt der exakten Wörter. Ermöglicht bedeutungsbasierte Suche: „wasserdichte Jacke" findet auch „Regenschutzbekleidung".
- Vektor-Datenbank: Spezialisierte Datenbank für Embeddings. Ermöglicht schnelle Ähnlichkeitssuche über Millionen von Textabschnitten. PostgreSQL mit pgvector ist eine bewährte, kosteneffiziente Variante.
- Chunking: Das Zerteilen von Dokumenten in kleine, sinnvolle Abschnitte für die Vektordatenbank. Die Chunk-Größe und -Strategie beeinflusst die Qualität der Suchergebnisse massiv. Zu groß: unpräzise Treffer. Zu klein: fehlender Kontext.
- Halluzination: Wenn ein KI-Modell Fakten erfindet und sie überzeugend als wahr präsentiert. RAG reduziert dieses Problem, weil das Modell auf echten Dokumenten basiert statt auf Vermutungen.
- LLM (Large Language Model): Großes Sprachmodell wie GPT-4, Claude oder Mistral. Der Teil des RAG-Systems, der die gefundenen Textabschnitte in eine verständliche Antwort umformuliert.
- DSGVO-Konformität: Datenschutz-Grundverordnung der EU. Für RAG-Systeme relevant, weil Firmendaten verarbeitet werden. Europäische Anbieter und Server vermeiden das CLOUD-Act-Risiko durch US-Unternehmen.
- Hybrid Retrieval: Kombination aus Vektor-Suche (Bedeutung) und klassischer Keyword-Suche für bessere Trefferquoten. Fängt Fälle ab, die reine Bedeutungssuche übersieht.
- MCP (Model Context Protocol): Von Anthropic entwickelter Standard, über den KI-Agenten mit externen Tools kommunizieren. Ermöglicht RAG-Systemen die Anbindung an Kalender, CRM, E-Mail und andere Unternehmenssoftware.
- GEO (Generative Engine Optimization): Optimierung von Website-Inhalten, damit KI-Suchmaschinen wie ChatGPT, Perplexity oder Claude die eigene Firma in ihren Antworten empfehlen. Verwandt mit RAG, weil KI-Suchmaschinen intern eigene RAG-Systeme betreiben.
Aus der Praxis
Die Thematik des Beitrages haben wir bei jukeep, einem unserer Projekte, umgesetzt. Mehr Infos dazu unter Projekte.
Autor