Wenn Zahlen im KI-System Kontext verlieren
07.10.2026·7 Min. Lesezeit·von David Paci
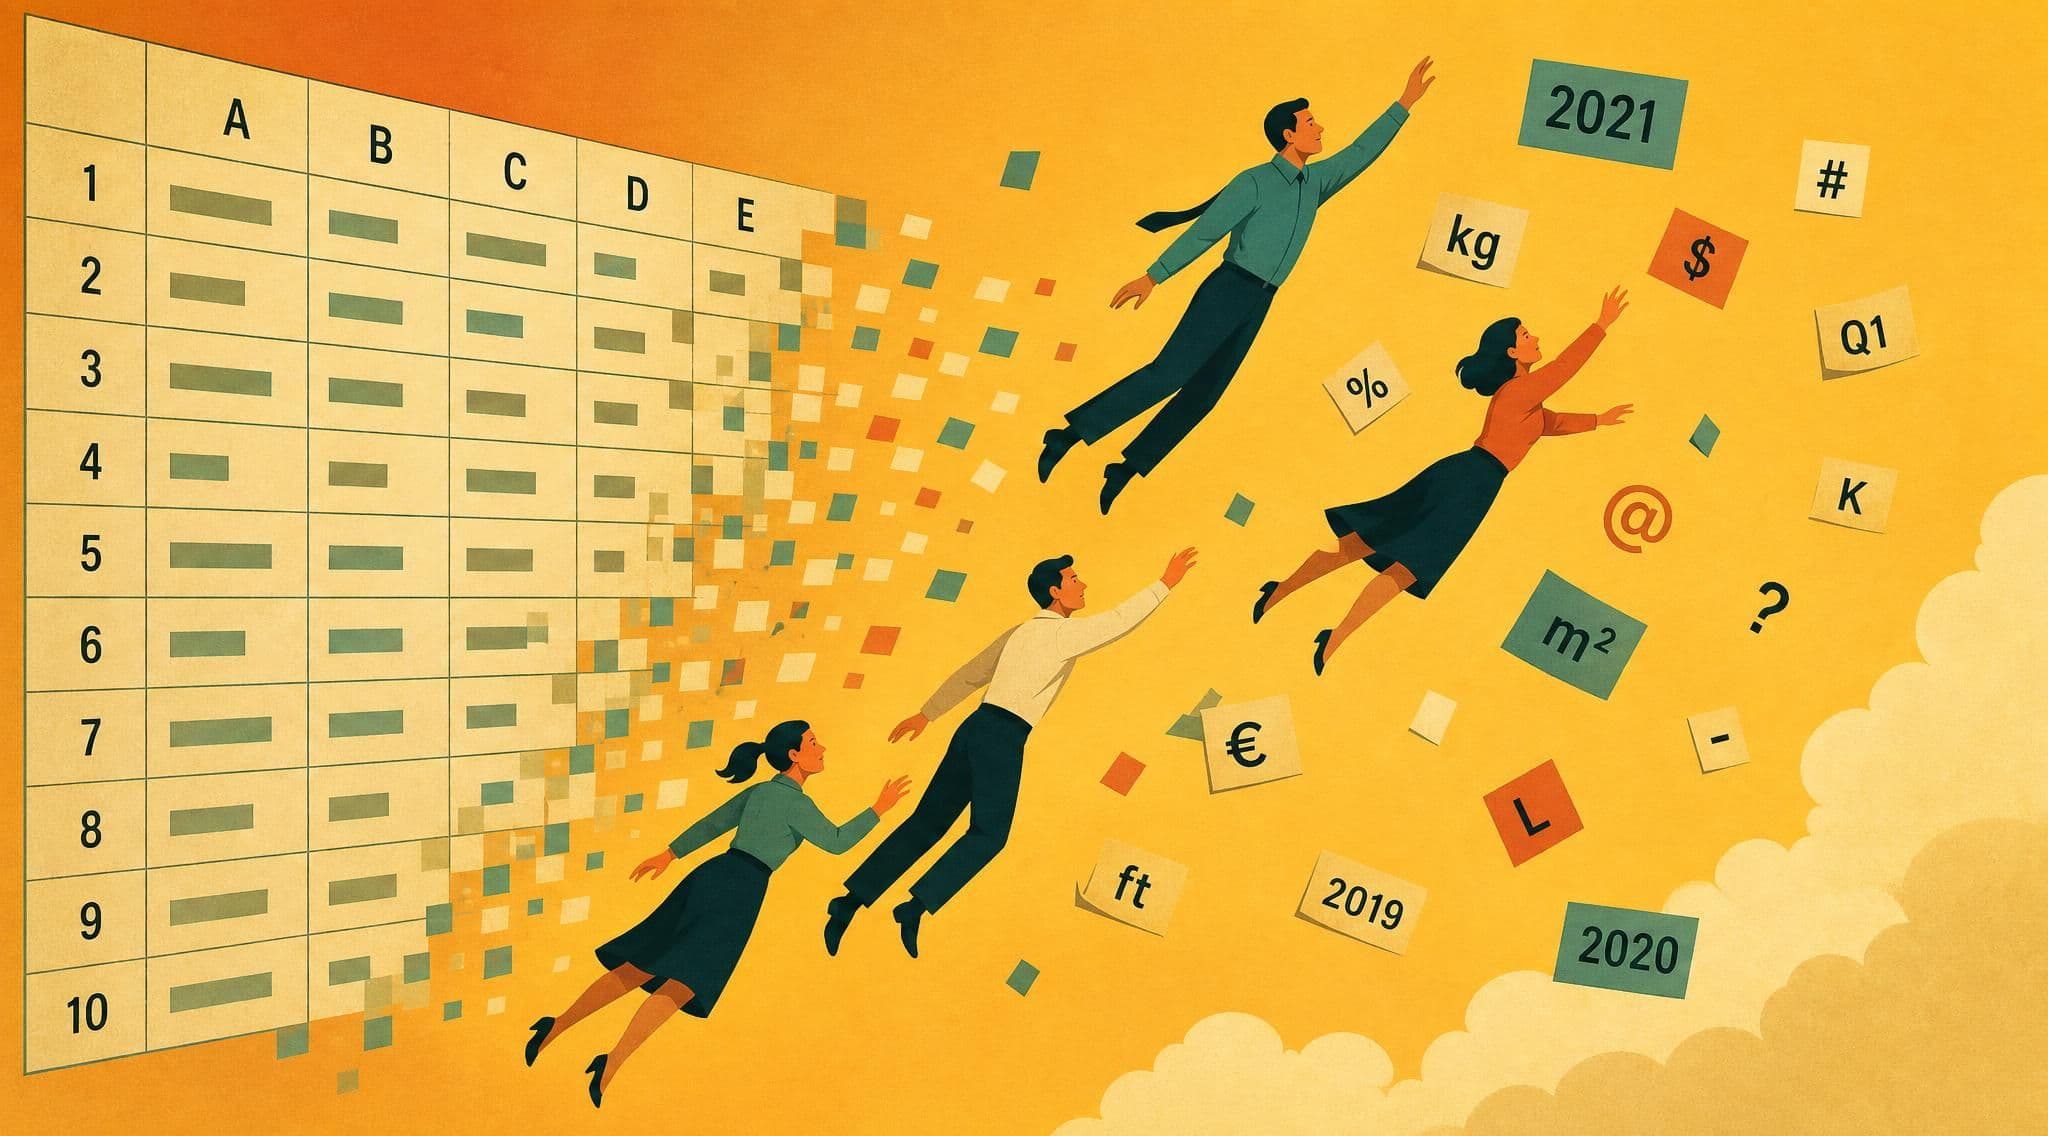
Bild KI-generiert
Eine Zahl in einer Tabelle ist selten selbsterklärend. Ob 4.250 einen Preis, eine Menge oder einen Jahreswert bezeichnet, ergibt sich meist erst aus der Zeilen- oder Spaltenüberschrift. Auch Einheit, Zeitraum oder Bezugsgröße stehen oft nicht direkt neben dem Wert. Für Menschen ist dieser Zusammenhang beim Lesen selbstverständlich. Bei KI-Wissenssystemen kann er bereits beim Einlesen des Dokuments verloren gehen, weil lange Dateien für die spätere Suche in kleinere Textstücke zerlegt werden. Dieses Verfahren nennt man Chunking.
Wie schnell dabei Bedeutung verloren geht, zeigt die Studie „Beyond Top-K: Replacing Black-Box Retrieval with Interpretable Agentic Operations“ von Sagar Tamang, Ayush Vyas und Tabarakul Hazarika aus dem August 2026. Die Autoren untersuchten unter anderem einen 780 Seiten langen Finanzbericht, bei dem 86,8 Prozent der Inhaltszeilen aus Tabellen bestanden. Die zu einer Zahl gehörende Einheit stand im Median 13 Zeilen entfernt, in einzelnen Fällen sogar 143 Zeilen. Wurde das Dokument in Textstücke mit 800 Zeichen zerlegt, fehlte bei 67,4 Prozent der Chunks mit Zahlen die zugehörige Einheit.
Das ist besonders problematisch, wenn ein Dokument mit unterschiedlichen Einheiten arbeitet. Im untersuchten Bericht kamen unter anderem Lakh und Crore vor. Zwischen beiden liegt ein Faktor von 100. Eine Zahl kann also korrekt aus dem Dokument übernommen worden sein und trotzdem eine völlig andere Bedeutung bekommen, wenn ihre Einheit beim Einlesen verloren gegangen ist.
Das Problem entsteht vor der Suche
Bei RAG-Systemen wird häufig darüber gesprochen, wie gut die Suche passende Textstellen findet. Bei Tabellen liegt ein Teil des Problems aber schon davor. Wenn ein Dokument beim Einlesen ungünstig zerlegt wird, kann die Zahl in einem Chunk landen und ihre Überschrift in einem anderen. Die spätere Suche arbeitet dann nur noch mit diesen Ausschnitten und kann den verlorenen Zusammenhang nicht ohne Weiteres rekonstruieren.
Die Studie zeigt auch, dass größere Chunks das Problem zwar reduzieren, aber nicht vollständig lösen. Bei 2.000 Zeichen fehlte die Einheit noch bei 18,0 Prozent der Textstücke mit Zahlen. Ein tabellenbewusstes Zerlegen senkte diesen Anteil auf 0,3 Prozent. Gleichzeitig fehlte bei 28,9 Prozent weiterhin das zugehörige Jahr.
Die Größe eines Chunks allein sagt deshalb wenig darüber aus, ob eine Tabelle korrekt verarbeitet wird. Entscheidend ist, ob fachlich zusammengehörende Informationen auch technisch zusammenbleiben.
Das lässt sich an einem einfachen Beispiel zeigen:
| Inhalt im Dokument | Was die Zahl bedeutet | Was beim Chunking verloren gehen kann |
|---|---|---|
| „Alle Beträge in Tsd. Euro“ im Tabellenkopf | 425 bedeutet 425.000 Euro | Die Einheit |
| „Geschäftsjahr 2024/25“ über mehreren Spalten | Der Wert gehört genau zu diesem Jahr | Der Zeitraum |
| Produktname links, Preis rechts | Der Preis gehört zu diesem Produkt | Die Zuordnung |
| Zwei Werte weit auseinander | Beide müssen gemeinsam ausgewertet werden | Der Zusammenhang |
Tabellen funktionieren anders als Fließtext
In normalem Fließtext stehen Erklärungen meist nahe bei der Aussage, auf die sie sich beziehen. Tabellen verteilen Bedeutung dagegen über ihre Struktur. Eine Spaltenüberschrift kann für Dutzende Werte gelten, eine Einheit einmal oberhalb einer ganzen Tabelle stehen und ein Geschäftsjahr mehrere Spalten gleichzeitig betreffen.
Beim Lesen verfolgen wir diese Beziehungen automatisch. Wir schauen nach oben zur Überschrift oder nach links zur Zeilenbezeichnung. Ein KI-System, das ein Dokument lediglich als Abfolge von Zeichen oder Absätzen behandelt, besitzt diese Orientierung nicht zwangsläufig.
Das betrifft nicht nur Finanzberichte. Dasselbe Muster findet sich in vielen Unterlagen, mit denen Unternehmen täglich arbeiten:
- Preislisten, bei denen die Einheit nur im Tabellenkopf steht
- Kalkulationen, bei denen mehrere Werte gemeinsam ausgewertet werden müssen
- Datenblätter, bei denen Maßeinheiten und technische Werte getrennt stehen
- Jahresabschlüsse, bei denen Jahr, Einheit und Kennzahl über mehrere Zeilen verteilt sind
Gerade bei Geldwerten, Mengen oder Fristen kann ein fehlender Zusammenhang gravierende Folgen haben. Der einzelne Wert sieht dabei oft völlig plausibel aus.
Manche Antworten brauchen mehrere Stellen zugleich
Eine weitere Schwierigkeit entsteht, wenn die Antwort nicht in einer einzelnen Tabellenzeile steckt. In einer Beispielfrage der Studie sollten zwei Werte aus einer Übersicht für das Geschäftsjahr 2024–25 miteinander verglichen werden. Zwischen beiden Zahlen lagen 47 Zeilen.
Eine klassische Vektorsuche muss in einem solchen Fall mehrere passende Textstellen finden und zugleich erkennen, dass sie gemeinsam ausgewertet werden müssen. Genau hier stößt ein Verfahren an Grenzen, das Dokumente primär als Sammlung einzelner Chunks behandelt.
Die Autoren testeten deshalb einen anderen Ansatz. Statt nur die ähnlichsten Ausschnitte auszuwählen, navigierte das System gezielt durch das Dokument. Es suchte nach konkreten Begriffen, sprang an passende Stellen und las dort begrenzte Bereiche im Zusammenhang.
Auf 51 geprüften Fragen erreichte dieses Verfahren laut „Beyond Top-K“ 58,8 Prozent richtige Antworten. Eine herkömmliche Vektorsuche kam auf 15,7 Prozent. Selbst eine nachgebesserte Variante der Vektorsuche erreichte mit 35,3 Prozent deutlich weniger.
| Verfahren | Richtige Antworten |
|---|---|
| Herkömmliche Vektorsuche | 15,7 % |
| Verbesserte Vektorsuche | 35,3 % |
| Navigation entlang der Dokumentstruktur | 58,8 % |
Diese Werte stammen aus einem konkreten Testaufbau und lassen sich nicht pauschal auf jedes Wissenssystem übertragen. Der Unterschied zeigt aber, wie wichtig die Struktur eines Dokuments für die Suche sein kann. Bei Tabellen reicht es oft nicht, einzelne Textstellen nach Ähnlichkeit zu sortieren.
Der Suchweg sollte bei Zahlen überprüfbar sein
Die Navigation durch die Dokumentstruktur hat noch einen weiteren Vorteil: Der Weg zur Antwort lässt sich leichter nachvollziehen.
Bei einer reinen Ähnlichkeitssuche erhält man typischerweise mehrere Treffer mit mathematischen Ähnlichkeitswerten. Daraus lässt sich nur begrenzt erkennen, warum ein bestimmter Betrag ausgewählt wurde oder ob die zugehörige Tabellenüberschrift tatsächlich berücksichtigt worden ist.
Ein strukturierter Suchweg lässt sich konkreter prüfen. Das System kann beispielsweise zuerst eine Tabelle finden, anschließend die relevante Spalte bestimmen und danach den passenden Bereich lesen. Gerade bei Zahlen ist diese Nachvollziehbarkeit wertvoll, weil ein falscher Wert oft nicht sofort auffällt.
Unser Artikel über hybride Suche und Vektorsuche erklärt, warum unterschiedliche Fragen unterschiedliche Suchverfahren brauchen. Tabellen ergänzen diesen Punkt um eine weitere Ebene: Nicht nur die Frage entscheidet über den Suchweg, sondern auch die Struktur der Daten.
Eine grobe Einordnung sieht so aus:
| Deine Daten | Deine Frage | Das passende Verfahren |
|---|---|---|
| Fließtext, Handbücher, PDFs | „Was steht zu X?“ | Bedeutungsbasierte Suche |
| Zahlen und Tabellen | „Welcher Wert gehört zu Jahr Y?“ | Tabellen- oder strukturbezogene Suche |
| Mehrere verknüpfte Angaben | „Wie hängen diese Werte zusammen?“ | Navigation über mehrere Stellen |
| Exakte Begriffe | „Wo steht Artikelnummer X?“ | Exakte Suche |
Grundlagen zum Aufbau solcher Systeme findest du außerdem in unserem Artikel RAG: Was KMU wissen müssen.
Ein einfacher Test für das eigene System
Ob ein KI-Wissenssystem Tabellen sinnvoll verarbeitet, lässt sich mit einer bekannten Datei recht schnell prüfen. Geeignet ist eine Tabelle, bei der eine wichtige Information nicht direkt neben dem gesuchten Wert steht.
Für einen solchen Test reicht zum Beispiel:
- Nimm eine Preisliste oder einen Bericht, bei dem Einheit oder Jahr nur im Tabellenkopf stehen.
- Stelle eine Frage, deren Antwort ohne diese Information falsch oder mehrdeutig wäre.
- Prüfe anschließend nicht nur die Antwort, sondern auch die verwendete Quelle.
- Kontrolliere, ob Zahl, Einheit und Zeitraum tatsächlich gemeinsam gefunden wurden.
Bei einem bestehenden oder geplanten System ist außerdem eine einfache technische Frage an den Anbieter aufschlussreich:
Wie werden Tabellen beim Einlesen behandelt?
Eine Antwort, die sich nur auf die Chunk-Größe bezieht, greift zu kurz. Entscheidend ist, ob Tabellenköpfe, Zeilenbezeichnungen, Einheiten und zeitliche Angaben ihren Bezug zu den eigentlichen Werten behalten.
Häufige Fragen
Sind größere Chunks bei Tabellen automatisch besser?
Nein. In der untersuchten Studie sank der Anteil fehlender Einheiten bei größeren Textstücken deutlich. Andere Zusammenhänge, etwa das zugehörige Jahr, gingen trotzdem teilweise verloren.
Betrifft das nur Finanzberichte?
Nein. Das Grundproblem tritt überall dort auf, wo Zahlen ihre Bedeutung aus weiter entfernten Überschriften oder Tabellenstrukturen erhalten. Dazu gehören beispielsweise Preislisten, Kalkulationen oder technische Datenblätter.
Was sollte ich bei einem Wissenssystem konkret prüfen?
Stelle eine Frage, bei der die richtige Antwort von einer Einheit, einem Jahr oder einer Tabellenüberschrift abhängt. Prüfe anschließend, ob das System genau diese Information gemeinsam mit dem eigentlichen Wert gefunden hat.
Du möchtest wissen, ob dein Wissenssystem Tabellen und Zahlen mit dem richtigen Kontext verarbeitet? Wir prüfen das in einem technischen Audit. Sprich mit uns.
Autor